

 歆语健康发布于 2周前
 收藏专家
长期以来,2型糖尿病在临床实践中往往被视作一种高度均质化的疾病。其诊断与治疗决策在很大程度上依赖于糖化血红蛋白和空腹血糖等单一的血糖指标。然而,这种传统的临床路径正面临着前所未有的挑战。临床医生在日常诊疗中时常观察到,尽管不同患者的血糖数值高度相似,但其背后的病理生理机制、并发症发生风险以及对降糖药物的治疗应答却存在着巨大的异质性。这种现象提示我们,传统的临床诊断模式未能触及疾病的深层生物学本质,亟需向更为精准的疾病分型时代迈进。
为了突破这一瓶颈,学术界在过去十年中致力于对糖尿病进行重新分型。其中,2018年提出的Ahlqvist五分法模型开启了2型糖尿病精准化管理的先河。然而,这种经典的低维临床分型框架在实际应用中也逐渐暴露出分类重叠、时间稳定性差以及无法充分揭示深层生物学机制等局限。
近日,由王敏等学者发表在知名期刊上的研究《Enriched Metabolic Phenotyping Refines Phenotypic Resolution of Type 2 Diabetes》为这一难题提供了全新的破局思路。该研究深入探讨了如何通过富集代谢表型化来提升糖尿病的分型分辨率。本文将围绕该研究的核心发现,系统剖析2型糖尿病如何从传统的血糖指标管理走向更具生物学精准性的高维代谢表型分类。
传统五分法的低维局限:常规临床
指标难以完全映射复杂的病理生理机制
在精准医学的发展历程中,数据驱动的聚类研究为理解2型糖尿病的异质性提供了关键视角。基于常规临床变量的分型模型成功定义了四大代谢亚型,包括严重胰岛素缺乏型糖尿病、严重胰岛素抵抗型糖尿病、轻度肥胖相关型糖尿病和轻度年龄相关型糖尿病。这一框架不仅可重复性强,更在预测糖尿病肾病、心血管并发症以及代谢相关脂肪性肝病等特定风险方面展现出巨大的临床潜力。然而,当我们将该模型应用于更广泛、更动态的现实世界临床实践中时,其低维框架的局限性便逐渐显现。
这种局限性首先体现在分类的不确定性与重叠性。传统的聚类仅依赖于谷氨酸脱羧酶抗体、诊断年龄、体质指数、糖化血红蛋白以及基于稳态模型的胰岛功能和胰岛素抵抗指数等有限的常规参数。在病理生理学层面上,这几项静态指标实际上是多条复杂代谢通路交叉作用后的下游结果,而非上游动因。这就导致许多处于疾病过渡期或兼具多种病理特征的患者,在数学聚类中被划分到了边缘区域,产生了极高的分类模糊度。例如,一名同时具有中度胰岛素抵抗和轻度胰岛素分泌缺陷的患者,可能因微弱的数值漂移而在不同的随访节点被归入不同的亚型。
低维指标无法捕捉
亚型内部的生物学异质性
以严重胰岛素抵抗型糖尿病患者为例,尽管他们在稳态模型评估的胰岛素抵抗指数上均表现出显著的抵抗,但其抵抗的靶器官究竟是主要局限于骨骼肌的葡萄糖摄取障碍,还是主要表现为肝脏糖异生增强,抑或是脂肪组织的异常脂质降解,在常规临床指标中是完全无法区分的。这种机制上的混杂,直接导致了同属一个亚型的患者对同一类药物的疗效反应大相径庭。因此,传统的低维临床分型无法作为制定个体化精准治疗方案的终极依据,亟需向高维度的深层代谢表型演进方式迈进。
高维度代谢表型:深层病理
生理学指标显著提升糖尿病分型的分辨率
正是基于上述未满足的临床需求,王敏等学者的最新研究通过富集代谢表型化,对2型糖尿病的分型分辨率进行了深度提炼与重构。该研究的核心假设在于,通过引入超越常规筛查的深层代谢及病理生理学指标,能够显著打破既往低维框架的局限,提供一个更高清、更接近疾病生物学本质的多维代谢流画像。这犹如将医学影像的屏幕分辨率从早期的标清提升至当下的超高清,使原本模糊的亚型边界变得清晰可见。
在这一创新的研究设计中,研究团队不再局限于常规的静态血糖和胰岛素数值,而是整合了更为丰富的代谢变量。这些变量包括精细的脂质亚类分析、肝脏脂肪含量的量化评估、动态糖耐量试验中的多时点胰岛素释放动力学,甚至分子层面的代谢物谱。通过将这些高维数据融入先进的数据驱动聚类算法,研究发现,原本在传统五分法中显得边界模糊、难以归类的中间态患者,在高维代谢空间中被赋予了极为独特的生物学标签。
这种富集的表型解析不仅在数学上降低了聚类分类的熵值,更在病理生理学上实现了对胰岛素抵抗和胰岛素分泌缺陷的精准解耦。举例而言,在常规分型中被粗略归为轻度肥胖相关型的患者,在引入脂质谱和炎症因子等富集表型后,被进一步分化为良性代谢肥胖型和异位脂质沉积伴重度炎症型。两者的胰岛细胞衰退轨迹截然不同,后者往往伴随着更为隐匿但进展迅速的微血管病变。由此可见,富集代谢表型化并非简单的指标堆砌,而是通过对代谢网络的深层透视,实现了对糖尿病异质性在生物学本质层面的高精度还原。
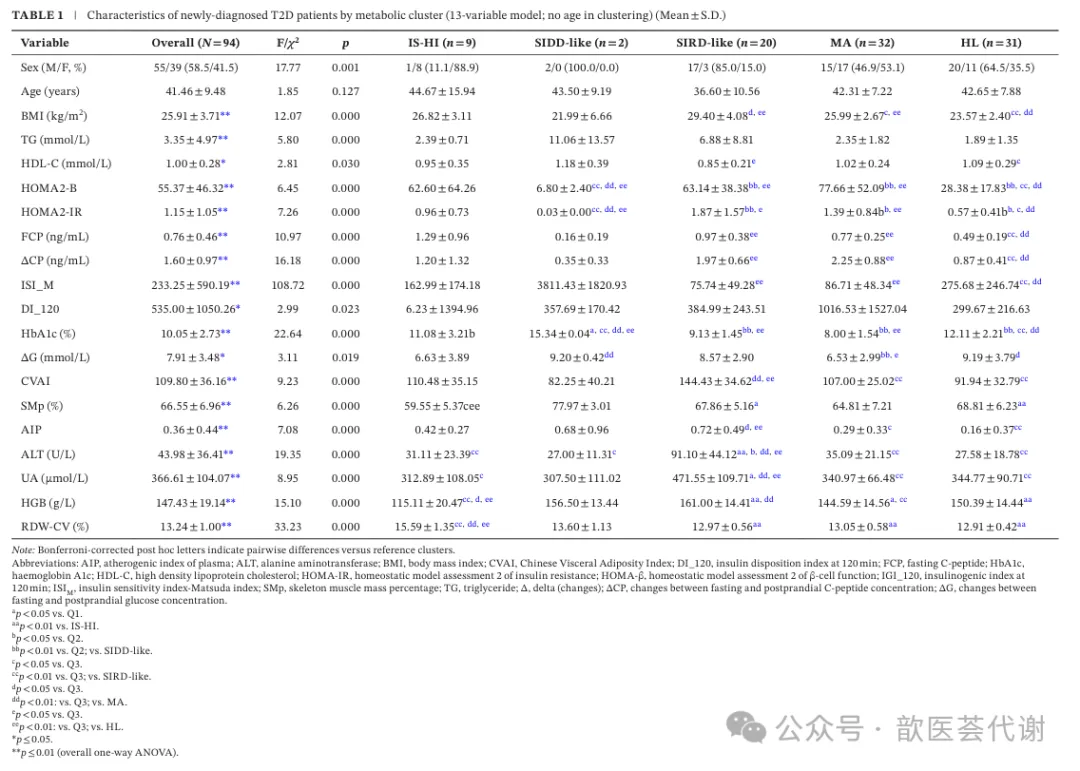 表1,基于代谢聚类的新诊断2型糖尿病(T2D)患者特征(13变量模型;聚类分析中未纳入年龄因素)(均值±标准差)
从对症降糖走向机制靶向:高分辨率
分型为精准治疗与并发症预测指明方向
富集代谢表型化在理论上的突破,其最终归宿必然是推动临床诊疗路径的根本性变革。在传统的2型糖尿病管理模式中,治疗决策往往遵循阶梯式的对症用药原则,即当糖化血红蛋白达不到靶标时,依据指南推荐依次叠加二甲双胍、钠葡萄糖共转运蛋白2抑制剂或胰高血糖素样肽1受体激动剂。这种模式忽略了患者个体的核心致病驱动力。而基于高分辨率代谢表型,临床医生得以将目光从血糖数值转移至靶向机制,实现真正意义上的个体化精准施治。
具体而言,对于通过高分辨率分型确诊为以肝脏胰岛素抵抗和脂毒性为主要特征的亚型,治疗的重心应立即锁定于改善异位脂肪沉积与减轻肝脏糖输出,此时早期联用强效体重管理药物和吡格列酮将具有极高的获益产出比。相反,对于表型富集后显示以第一时相胰岛素分泌极度匮乏、伴有特定氨基酸代谢异常的早期严重胰岛素缺乏型亚型,过早叠加增敏剂可能收效甚微,而尽早启动具备β细胞保护作用的机制靶向治疗,如高选择性肠促胰素受体激动剂联合早期精准营养干预,则能更有效地延缓残存β细胞的功能衰退轨迹。这种靶向治疗策略,避免了传统治疗中反复试错带来的时间窗口流失与胰岛衰退。
此外,高分辨率分型在并发症的超早期预测和精准分层管理中展现出了独特的优势。研究表明,糖尿病肾病和心血管疾病的发生并非均衡分布于所有2型糖尿病患者中,而是与特定的高维代谢特征高度关联。例如,通过富集代谢谱捕获到的某些特定游离脂肪酸亚类及支链氨基酸的异常蓄积,其对心血管事件的预测效能显著优于传统的低维指标。这意味着,在患者尚未出现靶器官器质性损伤的阶段,临床医生便能凭借高分辨率的表型预警,对高危患者启动干预,从而将糖尿病管理从被动治疗已发并发症彻底推向主动预防高危病变的新维度。
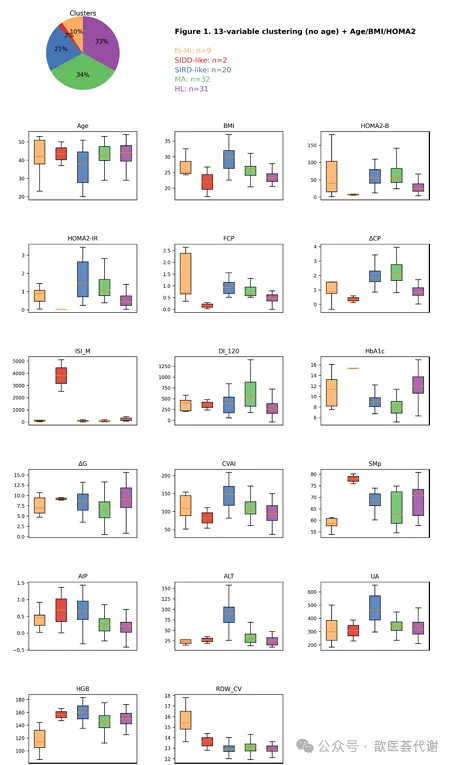 图1,采用13变量(不包含年龄)的模型对新诊断2型糖尿病患者进行代谢聚类分析
采用基于主成分分析(PCA)引导的13变量模型(排除年龄因素),对新诊断2型糖尿病成人患者进行数据驱动的代谢聚类分析;左上图展示各聚类组患者所占比例;右上图显示各聚类组的样本量:箱线图展示不同聚类组间代谢变量的分布情况,包括:胰岛素分泌指标:空腹C肽、ΔC肽;胰岛素敏感性指标:Matsuda指数;β细胞代偿功能指标:DI120(120分钟处置指数);血糖暴露指标:HbA1c、Δ葡萄糖;内脏脂肪指标:CVAI(内脏脂肪指数);骨骼肌指标:骨骼肌百分比;脂质风险指标:血浆致动脉粥样硬化指数(atherogenic index of plasma,AIP);肝脏代谢指标:丙氨酸氨基转移酶(ALT);嘌呤代谢指标:尿酸;血液学指标:血红蛋白和红细胞分布宽度。
研究识别出5种具有不同代谢特征的亚型:胰岛素敏感性高胰岛素血症型(IS-HI,insulin-sensitive hyperinsulinemia);严重胰岛素缺乏型(SIDD-like,severe insulin-deficient);严重胰岛素抵抗型(SIRD-like,severe insulin-resistant);肌源性–贫血型(MA,myogenic–anaemia);肝脏脂毒性型(HL,hepato-lipotoxic)。
箱线图显示中位数、四分位距以及1.5×四分位距范围内的须线(四分位距IQR = Q3−Q1)。
拓展阅读:
随着富集代谢表型研究的深入,多组学与代谢通量组学正成为破译2型糖尿病生物学异质性的利器。传统的表型分析主要依赖于循环代谢物的静态浓度测定,这仅能反映代谢网络的瞬时状态。而通量组学通过引入稳定同位素示踪技术,能够动态定量测量细胞内外的代谢转化速率与分子流向,从而在功能层面上揭示底物利用的精细动力学特征。将基因组学、转录组学以及基于质谱的高通量代谢组学数据与动态通量图谱相结合,研究者得以在系统生物学高度上绘制出个体的代谢网络流画像。这种深度的技术融合,不仅能精准定位导致胰岛素信号通路中断的具体酶靶点,还为发现全新的循环生物标志物提供了可能,从而为构建高度动态、预测性强的糖尿病精准分型数学模型奠定了坚实的科学基石。
观点评述
王敏等学者发表的这项关于富集代谢表型化的工作,其深远意义不仅在于提供了一个更为精细的糖尿病分类工具,更在于它向临床医学传递了一个核心哲学:必须超越血糖的表象,去探寻代谢的本质。从单一血糖指标达标向多维代谢 network 稳态的认知跃升,是糖尿病精准医学发展的重要里程碑。这项研究强有力地论证了,只有将临床分型建立在深层的病理生理机制之上,我们才能摆脱目前糖尿病防治领域中并发症居高不下、药物响应个体差异巨大的困境。
然而,我们也必须客观地认识到,高分辨率分型通往临床常规实践的道路依然漫长且充满挑战。高维度代谢表型检测所需的生命科学分析和计算成本,对精密检测设备的依赖,以及数据分析的复杂性,是其目前无法在基层医院大面积推广的主要屏障。此外,如何在庞大的多维数据中剔除环境、饮食及急性应激带来的瞬时噪声,提炼出具有长期遗传与病理稳定性、且易于在临床操作的简化版高分辨率指标组合,也是未来研究必须攻克的难题。
展望未来,人工智能与机器学习算法的发展有望为这一瓶颈提供解决方案。通过利用大型多组学队列训练预测模型,我们或许能够实现以简驭繁,即仅利用少数常规、廉价的临床检验指标,便能高精度地预测出患者在多维空间中的富集代谢表型。同时,未来的临床试验亟需引入表型分层设计,以验证基于高分辨率分型制定的治疗决策是否确实在长期硬终点上优于现行的指南标准治疗。唯有如此,2型糖尿病的精准管理才能真正从学术殿堂走向诊室案头,切实造福每一位异质性鲜明的糖尿病患者。
----------------------------------
☆本文仅供医疗卫生等专业人士参考
参考文献
1.Wang M, Ou Y, Su H, et al. Enriched Metabolic Phenotyping Refines Phenotypic Resolution of Type 2 Diabetes. Diabetes Obes Metab. 2026;28(8):6674-6686. doi: 10.1111/dom.70866. PMID: 42108427.
2.Ahlqvist E, Prasad RB, Groop L. Subtypes of Type 2 Diabetes Determined From Clinical Parameters. Diabetes. 2020;69(10):2086-2093. doi: 10.2337/dbi20-0001. PMID: 32843567.
声明:歆医荟代谢所发表内容之知识产权为歆医荟及原作者等相关权利人所有。未经许可,禁止进行转载、摘编、复制、裁切、录制等。经许可授权使用,亦须注明来源。欢迎转发、分享。